Himel3

越挖,
越深。
Himel3 是一個不急於回答的模型。它把問題分成層,一直走到理由所在的地方,然後才開口。
算術表現有哪些變化
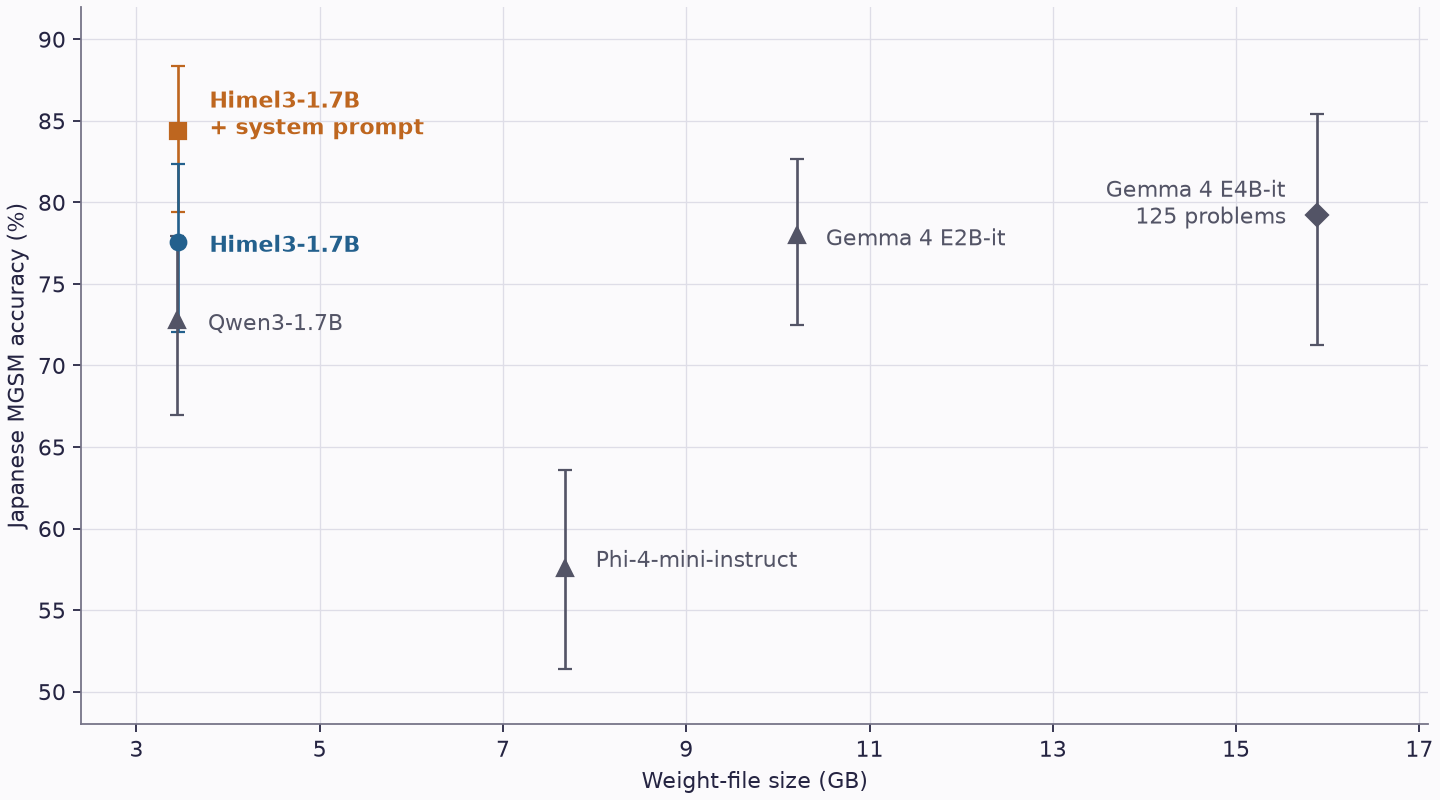
為 Himel3-1.7B 加入系統提示後,日語 MGSM 正確率從 77.6% 升至 84.4%(+6.8 個百分點,配對 McNemar 檢定 p=0.0046),英語從 92.8% 升至 94.0%。
橫向捲動表格可查看更多欄。
| 模型與設定 | 日語(%) | 英語(%) | 日語平均輸出 token 數 | 日語達到輸出上限(%) |
|---|---|---|---|---|
| Himel3-1.7B | 77.6 [72–82] | 92.8 [89–95] | 1,627 | 5.2 |
| Himel3-1.7B + system prompt | 84.4 [79–88] | 94.0 [90–96] | 1,478 | 1.2 |
| Himel3-1.7B-graft | 78.4 [73–83] | 94.4 [91–97] | 1,708 | 4.8 |
| Himel3-1.7B-graft + system prompt | 82.4 [77–87] | 94.4 [91–97] | 1,564 | 4.8 |
| LFM3-1.7B | 75.6 [70–81] | 93.6 [90–96] | 1,859 | 6.0 |
| Qwen3-1.7B | 72.8 [67–78] | 92.4 [88–95] | 1,980 | 3.2 |
| Gemma 4 E2B-it | 78.0 [72–83] | — | 989 | 0.0 |
| Gemma 4 E4B-it | 79.2 [71–85] (n=125) | — | 914 | 0.0 |
| Phi-4-mini-instruct | 57.6 [51–64] | — | 346 | 0.0 |
每種語言 250 題,只有 Gemma 4 E4B-it 的日語結果來自 125 題。方括號內為 95% Wilson 信賴區間,— 表示沒有完成的評估。
 查看大圖
同一題目上的配對比較
在相同的 250 道日語題目中,加入系統提示的 Himel3-1.7B 比 Qwen3-1.7B 高 11.6 個百分點(84.4% 對 72.8%,p=0.000015),比 Gemma 4 E2B-it 高 6.4 個百分點(78.0%,p=0.0090)。
在 Gemma 4 E4B-it 完成的 125 題中,加入系統提示的 Himel3-1.7B 為 82.4%,E4B-it 為 79.2%(p=0.45)。在全部 250 題中,graft 版有系統提示時為 82.4%,無提示時為 78.4%。使用系統提示時,標準版與 graft 版之間的差異未達統計顯著(p=0.40)。
評估方式與已知限制
標為「+ system prompt」的條件使用以下系統訊息。 You are a helpful assistant trained by Liquid AI.
評估在 Apple M1 Max(32 GB)的 MLX 上執行,採用各模型的對話範本,並在支援時啟用思考模式。取樣 temperature 為 0.6、top-p 為 0.95,輸出上限為 8,192 個 token。評分優先採用最後一個方框中的答案,否則採用最後一個數值。
模型主要採用 bf16,Phi-4-mini-instruct 採用 fp16。Qwen3.5 系列在此環境未能完成評估。比較範圍是算術,未評估工具使用、長上下文、代理工作流程、知識問答或長文件理解。
在日語 GSM8K 開發集的 300 題上,Himel3-1.7B 為 86.7%。這個開發集也用於調校。
Himel3-1.7B 達到輸出上限的比例,在無系統提示時為日語 5.2%、英語 2.4%,在有系統提示時為日語 1.2%、英語 1.6%。
模型與授權
Himel3-1.7B 與 Himel3-1.7B-graft 均採用 LFM Open License v1.0,源自 Liquid AI 的 LFM3-1.7B。