Himel3

掘るほど、
深くなる。
Himel3は、答えを急がないモデルです。問いを層に分け、理由のところまで降りてから、言葉にします。
算数の問題で、何が変わったか
Himel3-1.7B にシステムプロンプトを加えると、MGSM の正答率は日本語で77.6%から84.4%に上がり(+6.8ポイント、対応のある McNemar 検定で p=0.0046)、英語では92.8%から94.0%になりました。
スクロールすると、表の続きが見られます。
| モデル・設定 | 日本語(%) | 英語(%) | 日本語の平均出力トークン数 | 日本語の打ち切り率(%) |
|---|---|---|---|---|
| Himel3-1.7B | 77.6 [72–82] | 92.8 [89–95] | 1,627 | 5.2 |
| Himel3-1.7B + system prompt | 84.4 [79–88] | 94.0 [90–96] | 1,478 | 1.2 |
| Himel3-1.7B-graft | 78.4 [73–83] | 94.4 [91–97] | 1,708 | 4.8 |
| Himel3-1.7B-graft + system prompt | 82.4 [77–87] | 94.4 [91–97] | 1,564 | 4.8 |
| LFM3-1.7B | 75.6 [70–81] | 93.6 [90–96] | 1,859 | 6.0 |
| Qwen3-1.7B | 72.8 [67–78] | 92.4 [88–95] | 1,980 | 3.2 |
| Gemma 4 E2B-it | 78.0 [72–83] | — | 989 | 0.0 |
| Gemma 4 E4B-it | 79.2 [71–85] (n=125) | — | 914 | 0.0 |
| Phi-4-mini-instruct | 57.6 [51–64] | — | 346 | 0.0 |
各言語250問。Gemma 4 E4B-it の日本語のみ125問です。角括弧内は95% Wilson 信頼区間、— は完了した評価なしを示します。
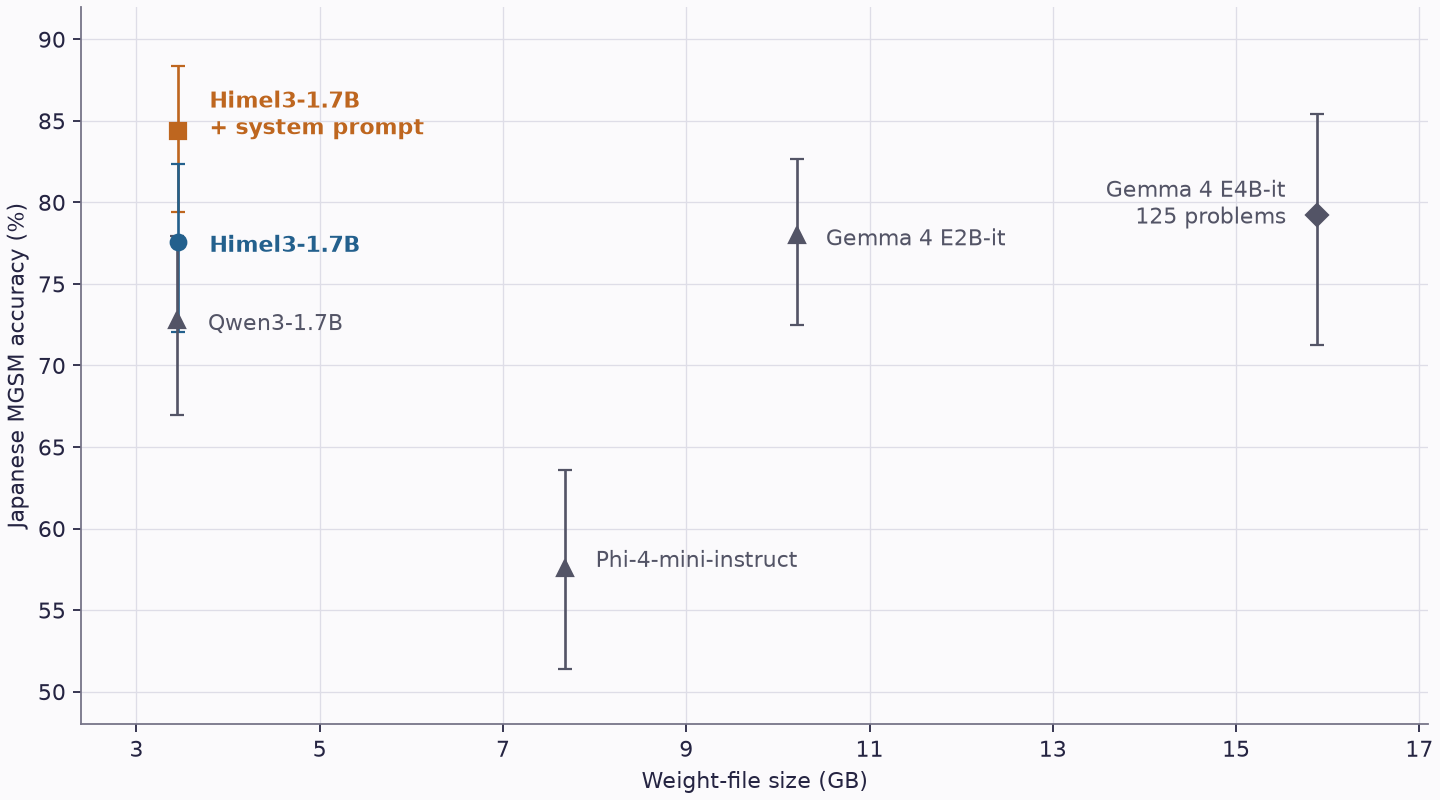 グラフを大きく表示
同じ問題でのペア比較
日本語の同じ250問で比べると、システムプロンプトありの Himel3-1.7B は Qwen3-1.7B より11.6ポイント高く(84.4% 対72.8%、p=0.000015)、Gemma 4 E2B-it より6.4ポイント高い結果でした(78.0%、p=0.0090)。
Gemma 4 E4B-it を評価した125問に揃えると、システムプロンプトありの Himel3-1.7B は82.4%、E4B-it は79.2%でした(p=0.45)。250問の graft 版はシステムプロンプトありで82.4%、なしで78.4%でした。システムプロンプトありで通常版と graft 版を比較した差は統計的に有意ではありませんでした(p=0.40)。
評価方法と既知の限界
表で「+ system prompt」と記した条件では、次の文をシステムメッセージとして渡しました。 You are a helpful assistant trained by Liquid AI.
Apple M1 Max(32 GB)上の MLX で、各モデルのチャットテンプレートを使い、対応する場合は思考モードを有効にしました。temperature 0.6、top-p 0.95、出力上限8,192トークンで、最後の枠付き解答を優先し、なければ末尾の数値を使って採点しました。
比較対象は主に bf16 で、Phi-4-mini-instruct は fp16 です。Qwen3.5 系はこの環境で評価を完了できませんでした。比較の範囲は算数です。ツール利用、長文脈、実際のエージェント運用、知識問題、長文の理解は評価していません。
日本語 GSM8K の開発用300問では Himel3-1.7B は 86.7% でした。この開発セットは調整にも使っています。
Himel3-1.7B が出力上限に達した割合は、システムプロンプトなしで日本語5.2%、英語2.4%、ありで日本語1.2%、英語1.6%でした。
モデルとライセンス
Himel3-1.7B と Himel3-1.7B-graft には LFM Open License v1.0 が適用されます。元モデルは Liquid AI の LFM3-1.7B です。