Himel3

越挖,
越深。
Himel3 是一个不急于回答的模型。它把问题分成层,一直走到理由所在的地方,然后才开口。
算术表现有哪些变化
为 Himel3-1.7B 加入系统提示后,日语 MGSM 正确率从 77.6% 升至 84.4%(+6.8 个百分点,配对 McNemar 检验 p=0.0046),英语从 92.8% 升至 94.0%。
横向滚动表格可查看更多列。
| 模型与配置 | 日语(%) | 英语(%) | 日语平均输出 token 数 | 日语达到输出上限(%) |
|---|---|---|---|---|
| Himel3-1.7B | 77.6 [72–82] | 92.8 [89–95] | 1,627 | 5.2 |
| Himel3-1.7B + system prompt | 84.4 [79–88] | 94.0 [90–96] | 1,478 | 1.2 |
| Himel3-1.7B-graft | 78.4 [73–83] | 94.4 [91–97] | 1,708 | 4.8 |
| Himel3-1.7B-graft + system prompt | 82.4 [77–87] | 94.4 [91–97] | 1,564 | 4.8 |
| LFM3-1.7B | 75.6 [70–81] | 93.6 [90–96] | 1,859 | 6.0 |
| Qwen3-1.7B | 72.8 [67–78] | 92.4 [88–95] | 1,980 | 3.2 |
| Gemma 4 E2B-it | 78.0 [72–83] | — | 989 | 0.0 |
| Gemma 4 E4B-it | 79.2 [71–85] (n=125) | — | 914 | 0.0 |
| Phi-4-mini-instruct | 57.6 [51–64] | — | 346 | 0.0 |
每种语言 250 道题,只有 Gemma 4 E4B-it 的日语结果来自 125 道题。方括号为 95% Wilson 置信区间,— 表示评估未完成。
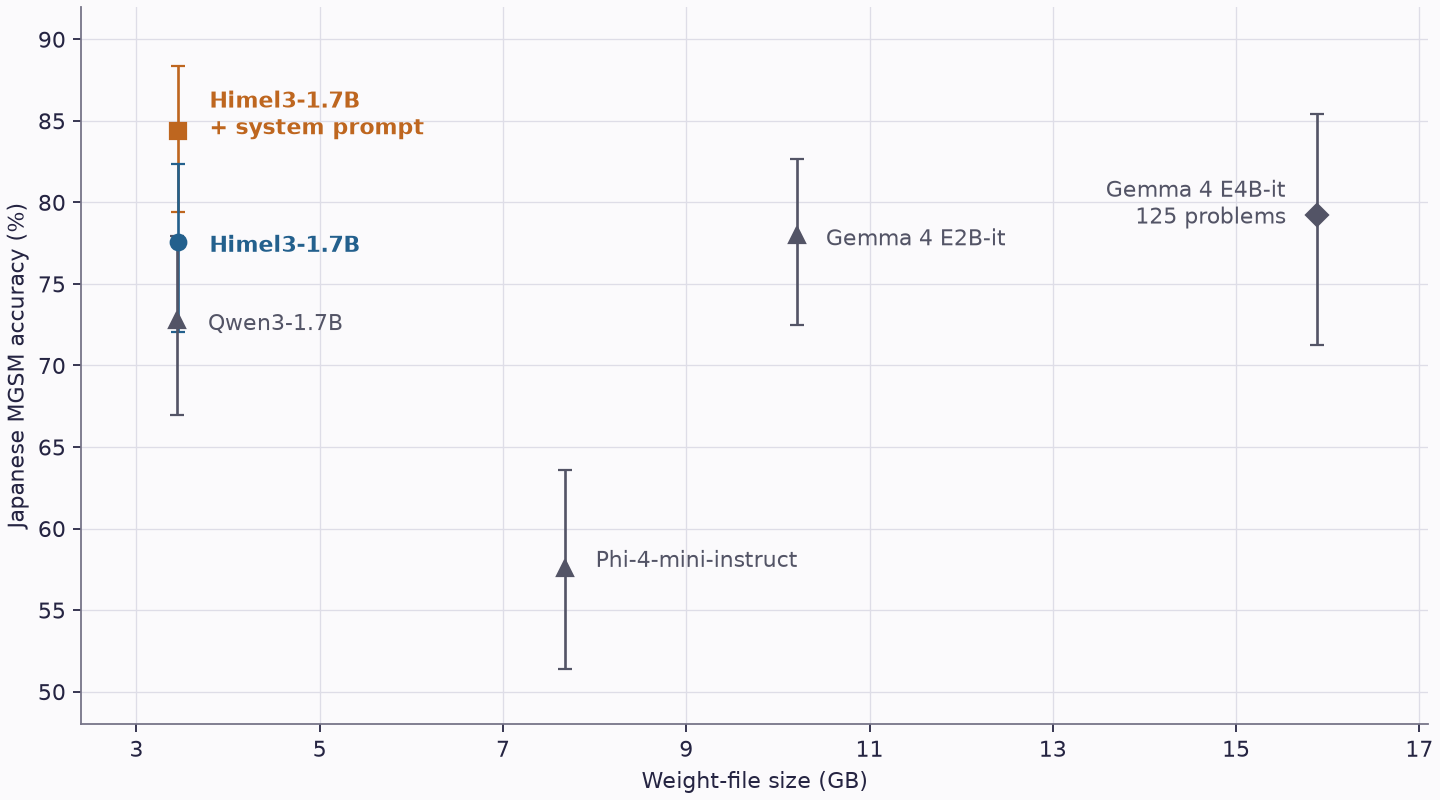 查看大图
同一题目上的配对比较
在相同的 250 道日语题上,带系统提示的 Himel3-1.7B 比 Qwen3-1.7B 高 11.6 个百分点(84.4% 对 72.8%,p=0.000015),比 Gemma 4 E2B-it 高 6.4 个百分点(78.0%,p=0.0090)。
在 Gemma 4 E4B-it 完成的 125 道题上,带系统提示的 Himel3-1.7B 为 82.4%,E4B-it 为 79.2%(p=0.45)。在全部 250 道题上,graft 版有系统提示时为 82.4%,无提示时为 78.4%。在有系统提示时,标准版和 graft 版之间的差异未达到统计显著性(p=0.40)。
评估方法与已知局限
标为“+ system prompt”的条件采用以下系统消息。 You are a helpful assistant trained by Liquid AI.
评估在 Apple M1 Max(32 GB)的 MLX 上完成,使用各模型自己的对话模板,并在支持时启用思考模式。采样 temperature 为 0.6、top-p 为 0.95,输出上限为 8,192 个 token。评分优先取最后一个带框答案,否则取最后一个数值。
模型主要使用 bf16,Phi-4-mini-instruct 使用 fp16。Qwen3.5 系列在本环境中未能完成评估。比较范围为算术,未评估工具调用、长上下文、智能体工作流、知识问答或长文档理解。
在日语 GSM8K 的 300 道开发集题目上,Himel3-1.7B 为 86.7%。调优时也使用了这套开发集。
Himel3-1.7B 达到输出上限的比例在无系统提示时为日语 5.2%、英语 2.4%,在有系统提示时为日语 1.2%、英语 1.6%。
模型与许可证
Himel3-1.7B 与 Himel3-1.7B-graft 均适用 LFM Open License v1.0,基于 Liquid AI 的 LFM3-1.7B。