Himel3

파면 팔수록,
더 깊어진다.
Himel3는 답을 서두르지 않는 모델입니다. 질문을 층으로 나누고, 이유가 있는 곳까지 내려간 다음에 말합니다.
산술 문제에서 무엇이 달라졌나
Himel3-1.7B에 시스템 프롬프트를 추가하자 일본어 MGSM 정답률이 77.6%에서 84.4%로 올랐습니다(+6.8%p, 대응 McNemar 검정 p=0.0046). 영어 MGSM은 92.8%에서 94.0%로 올랐습니다.
표를 가로로 스크롤하면 더 많은 항목을 볼 수 있습니다.
| 모델 및 설정 | 일본어(%) | 영어(%) | 일본어 평균 출력 토큰 수 | 일본어 출력 한도 도달률(%) |
|---|---|---|---|---|
| Himel3-1.7B | 77.6 [72–82] | 92.8 [89–95] | 1,627 | 5.2 |
| Himel3-1.7B + system prompt | 84.4 [79–88] | 94.0 [90–96] | 1,478 | 1.2 |
| Himel3-1.7B-graft | 78.4 [73–83] | 94.4 [91–97] | 1,708 | 4.8 |
| Himel3-1.7B-graft + system prompt | 82.4 [77–87] | 94.4 [91–97] | 1,564 | 4.8 |
| LFM3-1.7B | 75.6 [70–81] | 93.6 [90–96] | 1,859 | 6.0 |
| Qwen3-1.7B | 72.8 [67–78] | 92.4 [88–95] | 1,980 | 3.2 |
| Gemma 4 E2B-it | 78.0 [72–83] | — | 989 | 0.0 |
| Gemma 4 E4B-it | 79.2 [71–85] (n=125) | — | 914 | 0.0 |
| Phi-4-mini-instruct | 57.6 [51–64] | — | 346 | 0.0 |
언어별로 250문항을 평가했습니다. Gemma 4 E4B-it의 일본어 결과만 125문항입니다. 대괄호는 95% Wilson 신뢰구간이고, —는 완료된 평가가 없음을 뜻합니다.
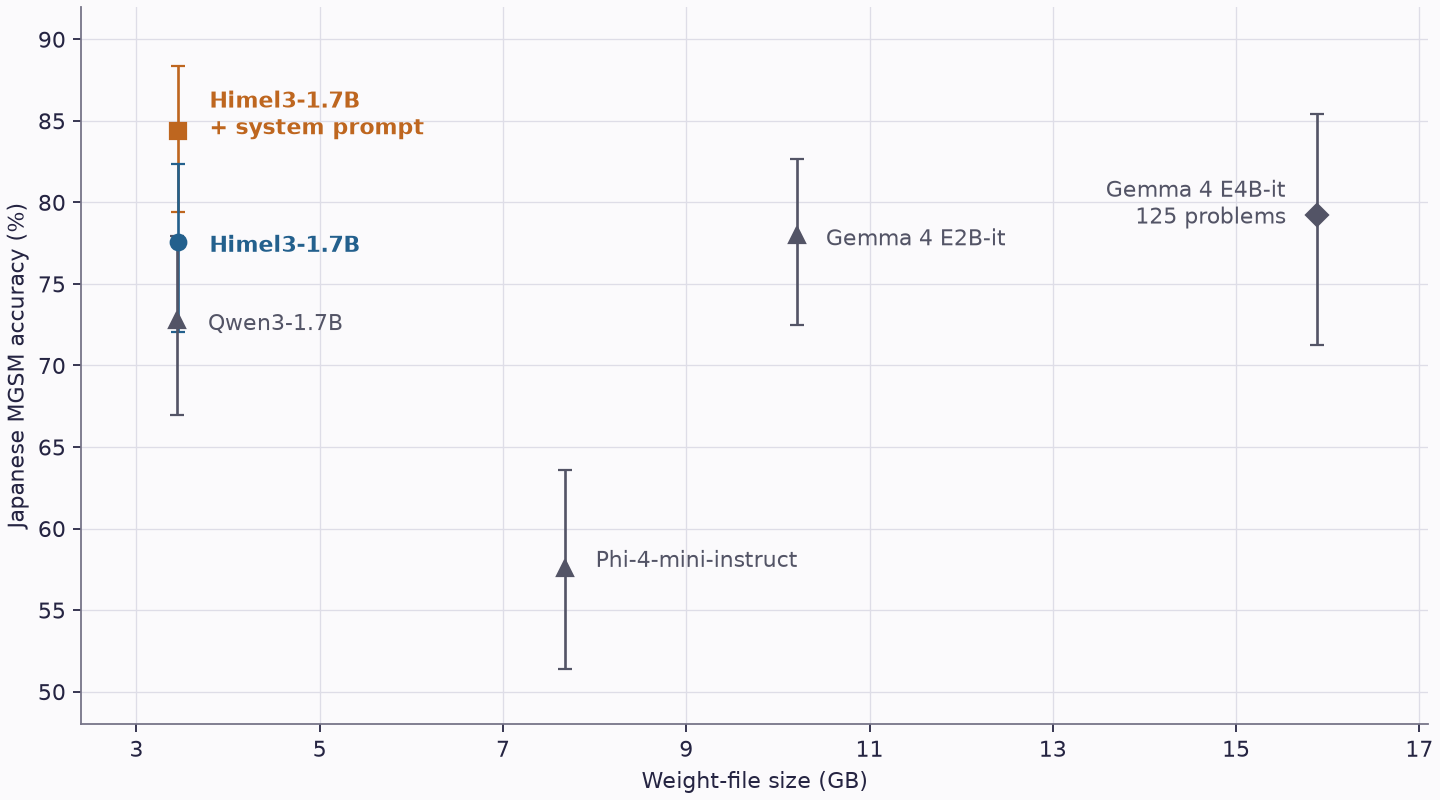 그래프 확대
같은 문제에 대한 쌍대 비교
같은 일본어 250문항에서 시스템 프롬프트를 사용한 Himel3-1.7B는 Qwen3-1.7B보다 11.6%p(84.4% 대 72.8%, p=0.000015), Gemma 4 E2B-it보다 6.4%p(78.0%, p=0.0090) 높았습니다.
Gemma 4 E4B-it가 완료한 125문항에서 시스템 프롬프트를 사용한 Himel3-1.7B는 82.4%, E4B-it는 79.2%였습니다(p=0.45). 전체 250문항에서 graft 버전은 시스템 프롬프트 사용 시 82.4%, 미사용 시 78.4%였습니다. 시스템 프롬프트 사용 시 일반판과 graft판의 차이는 통계적으로 유의하지 않았습니다(p=0.40).
평가 방법과 알려진 한계
“+ system prompt”로 표시된 조건에는 다음 시스템 메시지를 사용했습니다. You are a helpful assistant trained by Liquid AI.
Apple M1 Max(32 GB)에서 MLX로 평가했으며, 각 모델의 채팅 템플릿을 사용하고 지원되는 경우 사고 모드를 켰습니다. temperature 0.6, top-p 0.95, 최대 출력 8,192토큰이었고, 마지막 상자 안의 답을 우선 채점했고 상자가 없으면 마지막 수치를 사용했습니다.
모델은 bf16으로 실행했으며 Phi-4-mini-instruct는 fp16을 사용했습니다. Qwen3.5 계열은 이 환경에서 평가를 완료하지 못했습니다. 비교 범위는 산술이며 도구 사용, 긴 문맥, 에이전트 작업, 지식 문제, 긴 문서 이해는 평가하지 않았습니다.
일본어 GSM8K 개발 세트 300문항에서 Himel3-1.7B는 86.7%였습니다. 이 개발 세트는 조정 과정에도 사용했습니다.
Himel3-1.7B의 출력 한도 도달률은 시스템 프롬프트 미사용 시 일본어 5.2%, 영어 2.4%, 사용 시 일본어 1.2%, 영어 1.6%였습니다.
모델과 라이선스
Himel3-1.7B와 Himel3-1.7B-graft에는 LFM Open License v1.0이 적용됩니다. 두 모델 모두 Liquid AI의 LFM3-1.7B에서 파생되었습니다.