Himel3
Un modelo para
cavar más hondo.
Himel3 es un nuevo modelo de lenguaje de Philiaxis, el creador de Himel Agent.

Cuanto más cavas,
más hondo llega.
Himel3 es un modelo que no apresura sus respuestas. Separa la pregunta en capas y solo habla cuando ha llegado a las razones que hay debajo.
Qué cambió en las tareas de aritmética
Al añadir una instrucción de sistema a Himel3-1.7B, la tasa de aciertos en MGSM en japonés pasó del 77.6% al 84.4% (+6.8 puntos porcentuales, prueba pareada de McNemar p=0.0046). En inglés pasó del 92.8% al 94.0%.
Desplaza la tabla para ver más columnas.
| Modelo y configuración | Japonés (%) | Inglés (%) | Tokens de salida medios (japonés) | Límite de salida alcanzado (japonés, %) |
|---|---|---|---|---|
| Himel3-1.7B | 77.6 [72–82] | 92.8 [89–95] | 1,627 | 5.2 |
| Himel3-1.7B + system prompt | 84.4 [79–88] | 94.0 [90–96] | 1,478 | 1.2 |
| Himel3-1.7B-graft | 78.4 [73–83] | 94.4 [91–97] | 1,708 | 4.8 |
| Himel3-1.7B-graft + system prompt | 82.4 [77–87] | 94.4 [91–97] | 1,564 | 4.8 |
| LFM3-1.7B | 75.6 [70–81] | 93.6 [90–96] | 1,859 | 6.0 |
| Qwen3-1.7B | 72.8 [67–78] | 92.4 [88–95] | 1,980 | 3.2 |
| Gemma 4 E2B-it | 78.0 [72–83] | — | 989 | 0.0 |
| Gemma 4 E4B-it | 79.2 [71–85] (n=125) | — | 914 | 0.0 |
| Phi-4-mini-instruct | 57.6 [51–64] | — | 346 | 0.0 |
250 problemas por idioma, excepto Gemma 4 E4B-it en japonés (125). Los corchetes indican intervalos de confianza de Wilson del 95%. El guion indica que no hay un resultado completo.
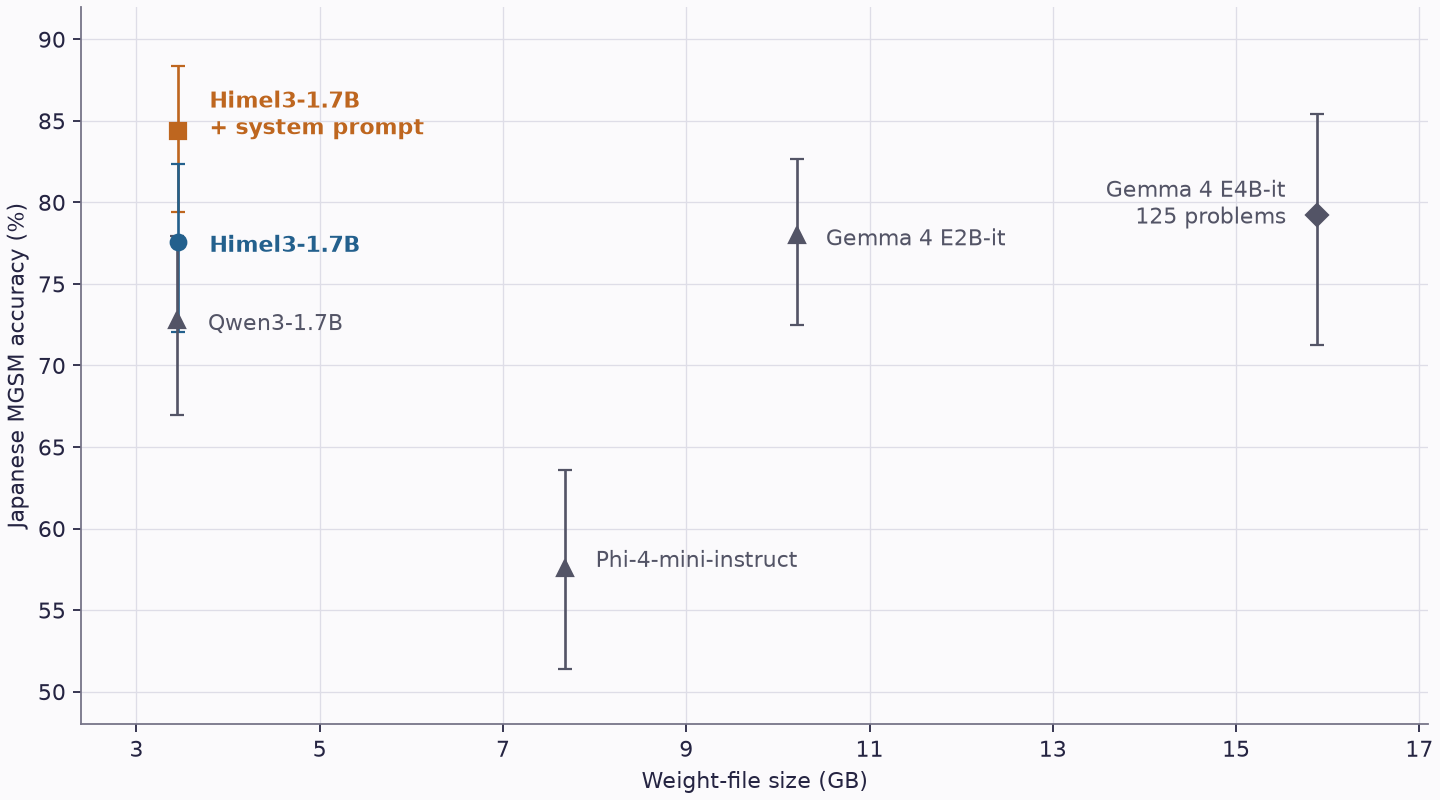 Ampliar el gráfico
Comparaciones pareadas en los mismos problemas
En los mismos 250 problemas en japonés, Himel3-1.7B con una instrucción de sistema obtuvo 11.6 puntos más que Qwen3-1.7B (84.4% frente a 72.8%, p=0.000015) y 6.4 puntos más que Gemma 4 E2B-it (78.0%, p=0.0090).
En los 125 problemas que completó Gemma 4 E4B-it, Himel3-1.7B con una instrucción de sistema obtuvo un 82.4% y E4B-it un 79.2% (p=0.45). En los 250 problemas, la variante graft obtuvo un 82.4% con instrucción de sistema y un 78.4% sin ella. Con la instrucción, la diferencia entre las variantes estándar y graft no fue estadísticamente significativa (p=0.40).
Método de evaluación y límites conocidos
En las filas «+ system prompt» usamos el siguiente mensaje de sistema. You are a helpful assistant trained by Liquid AI.
Ejecutamos las evaluaciones en MLX con un Apple M1 Max (32 GB), con la plantilla de chat de cada modelo y el modo de razonamiento activado cuando era compatible. Usamos temperature 0.6, top-p 0.95 y un máximo de 8,192 tokens de salida, puntuando la última respuesta entre llaves o, si no la había, el último número.
Los modelos se ejecutaron en bf16, salvo Phi-4-mini-instruct, que usó fp16. Las evaluaciones de Qwen3.5 no terminaron en este entorno. La comparación se limita a la aritmética. No evaluamos el uso de herramientas, el contexto largo, los flujos de agente, las preguntas de conocimiento ni la comprensión de documentos largos.
Himel3-1.7B obtuvo un 86.7% en los 300 problemas de desarrollo de GSM8K en japonés, que también usamos durante el ajuste.
Himel3-1.7B alcanzó el límite de salida en el 5.2% de los problemas en japonés y el 2.4% en inglés sin instrucción de sistema. Con ella, las tasas fueron del 1.2% y el 1.6%.
Modelos y licencia
Himel3-1.7B y Himel3-1.7B-graft se distribuyen bajo la LFM Open License v1.0. Ambos derivan de LFM3-1.7B de Liquid AI.